Natural Language Processing (NLP, também conhecido como text mining) é um termo abrangente para técnicas que permitem extrair informação de dados de texto. Estas técnicas são aplicadas na prática com graus variáveis de sucesso. Nos últimos anos, os rápidos avanços nas redes neuronais (sobretudo por parte de gigantes tecnológicos como a Google) conduziram a vários progressos importantes. Como funcionam? Até que ponto são estas novas técnicas úteis na prática? E funcionam também com dados de texto em neerlandês? É demasiado para um único artigo, por isso este será dividido em duas partes. Nesta primeira parte, analisamos em maior detalhe o conceito de
embeddings: uma forma de representar dados de texto que está na base dos avanços recentes. Na segunda parte, abordamos aplicações concretas e possibilidades específicas para texto em neerlandês.
O NLP não é um desenvolvimento dos últimos anos; existe há muito tempo. Em termos conceptuais, desde a década de 1950 e, na prática, desde cerca da década de 1990. Tópicos como
Named Entity Recognition,
Part-of-Speech tagging e
stemming & lemmatization fazem parte das ferramentas de NLP. As principais aplicações dos dados textuais são
semantic search,
análise de sentimento, topic modeling, classificação e clustering. Entre as técnicas mais usadas estão
bag-of-words,
tf-idf,
Naïve Bayes e
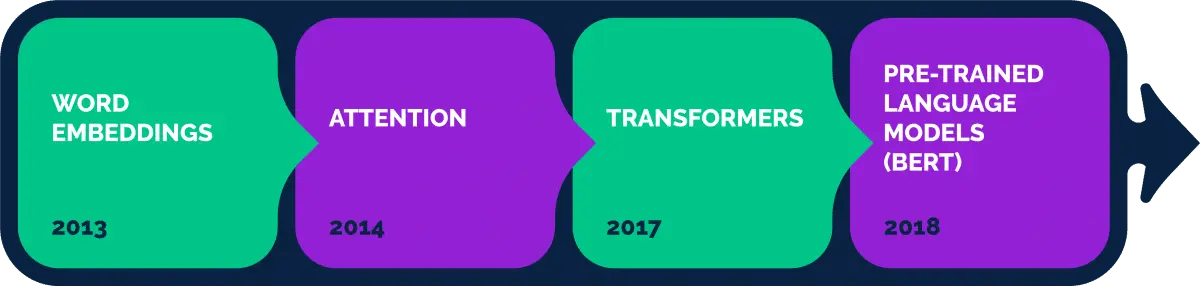
LDA. O que temos visto nos últimos anos é uma mudança para técnicas de NLP baseadas em redes neuronais. Tudo começou com a introdução do word2vec
[1] em 2013: uma espécie de dicionário que permite traduzir uma palavra para uma sequência de números com significado semântico (word embeddings). Estes embeddings foram muito usados em redes neuronais recorrentes. O princípio de
attention[2] melhorou a capacidade das redes neuronais de aprender e reter relações de mais longo prazo em trechos de texto. Com a chegada do
transformer[3], esta capacidade melhorou ainda mais e, atualmente, o foco está nos modelos de linguagem pré-treinados da família BERT
[4]. Assim, o
transfer learning tornou-se finalmente uma realidade no NLP, tal como já tinha acontecido com as redes neuronais convolucionais pré-treinadas em computer vision. Por ordem cronológica, os desenvolvimentos académicos mais importantes são, portanto:
Mas, como referimos, a aceleração começou com o word2vec e os word embeddings. Porque é isto tão importante? Porque muda radicalmente a forma como o texto é representado.
Representações de dados textuais
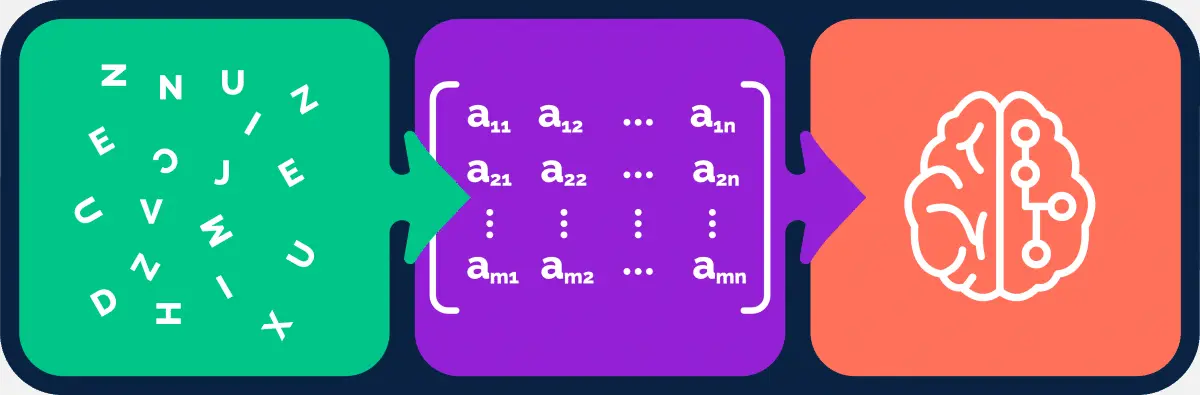
Um computador não consegue fazer cálculos com texto. Só com números. Se quisermos aplicar algoritmos a dados textuais, primeiro temos de ‘traduzir’ o texto para números. Por outras palavras: encontrar uma representação numérica.
Bag-of-words
Há muitos anos que a representação bag-of-words (BoW) é amplamente utilizada. A abordagem é simples. Imagine que tem um conjunto de documentos (excertos de texto). O processo é o seguinte:
- Identificar as palavras que aparecem
- Usá-las para criar um vocabulário
- Para cada documento, contar quantas vezes aparece cada palavra do vocabulário
- Cada documento passa a ser uma longa sequência de números
- O seu ‘corpus’ (conjunto de dados de texto) passa a ser uma matriz de números
- B. Muitas vezes, as palavras vazias são excluídas do vocabulário
Esta matriz de números pode então ser utilizada com vários algoritmos de classificação, clustering, topic modeling, etc. Muitas vezes, também se utiliza
tf/idf para atribuir um peso maior às palavras distintivas nesta matriz e um peso menor às palavras irrelevantes, mas esta técnica não é exclusiva do BoW. Qual é, então, o problema desta representação? A simplicidade do BoW é o seu ponto forte, mas também apresenta algumas limitações. Para compreender um texto, precisamos de:
- Compreender o significado de cada palavra
- Compreender a relação entre as palavras
Como se sai o BoW nestes aspetos?
- Compreender o significado de cada palavra
- Uma palavra é representada apenas por um índice que remete para o vocabulário. Não lhe é atribuído qualquer significado.
- Compreender a relação entre as palavras
- A ordem das palavras no texto é ignorada.
Dois exemplos para esclarecer:
- O BoW não deteta qualquer semelhança entre ‘animal’ e ‘bicho’, embora tenham significados quase idênticos
- Em contrapartida, o BoW considera estas frases exatamente iguais:
- “Não foi como eu esperava, este filme é excelente”
- “Foi como eu esperava, este filme não é excelente”
Word embeddings
A ideia central por detrás dos word embeddings é a hipótese distribucional[5] de John Firth:
“Uma palavra conhece-se pela companhia que mantém”.
Por outras palavras, é possível inferir o significado de uma palavra a partir do contexto em que aparece. É precisamente assim que funciona o algoritmo word2vec: analisa excertos de texto para identificar que palavras aparecem junto de determinadas palavras de contexto.
No exemplo de
The quick brown fox, isto pode não parecer muito útil. Mas, se o fizer com milhões ou até milhares de milhões de frases, começam a surgir padrões. Assim, obtém muitos dados para treinar um modelo (uma rede neuronal) que tenta prever as palavras do contexto a partir de uma determinada palavra. Pode parecer uma tarefa inútil e sem futuro, mas tem uma vantagem: como resultado secundário, obtém uma matriz com um conjunto de pesos (números) para cada palavra. E há algo de especial nestes números: o significado da palavra está, de facto, codificado neles e pode ser extraído! Como? Comparando números: podem estar próximos uns dos outros (81 e 82) ou distantes (2 e 81), o que pode ser interpretado como semelhança ou diferença. Como cada palavra é representada por vários números, é possível considerar diferentes tipos de semelhança. Veja o exemplo que se tornou canónico: “king – man + woman = queen”:
Vejamos os números obtidos (a que chamamos embeddings) para as quatro palavras “king”, “man”, “woman” e “queen” na imagem abaixo.
Destacam-se os seguintes aspetos:
- Alguns números/colunas (assinalados com cores abaixo) estão próximos quando comparamos “king” e “man”. Isto sugere que existe uma semelhança semântica entre estas duas palavras (e existe mesmo)
- O mesmo se aplica a “woman” e “queen”
- Existe uma semelhança semelhante entre “king” e “queen”, mas em números/colunas diferentes
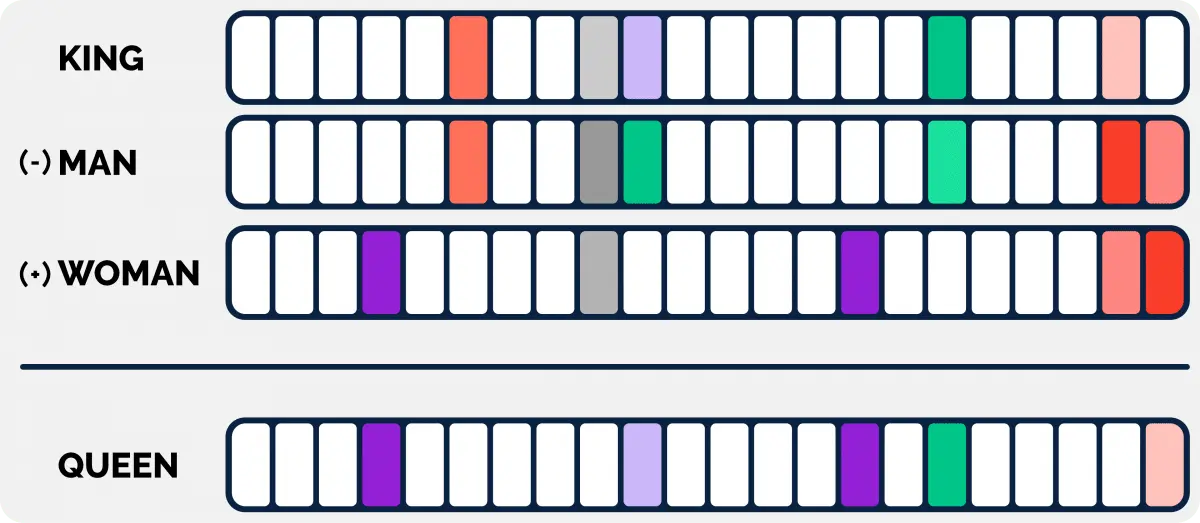
Do ponto de vista semântico, se pensar na palavra “rei” e substituir a componente masculina pela feminina, chega a “rainha”. E é precisamente isso (bem, quase precisamente) que acontece quando faz o cálculo equivalente com os word embeddings destas palavras! Isto sugere que alguns números no embedding dizem respeito ao género e outros à ‘realeza’. Imagine agora que os embeddings têm apenas três números (na realidade, têm centenas ou até milhares) e que representa esses números como pontos num espaço 3D. Assim, pode visualizar as relações entre as palavras:
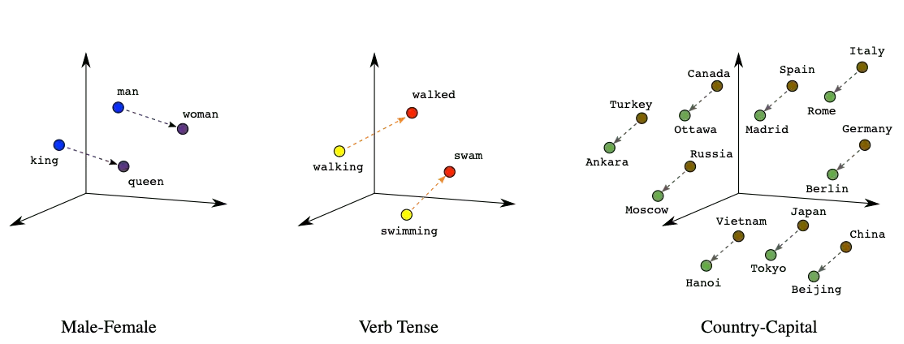
Se quiser descobrir mais algumas relações interessantes e surpreendentes, recomendo este artigo:
https://graceavery.com/word2vec-fish-music-bass/
Word embeddings como transfer learning
Como pode obter esses word embeddings? Geralmente, não precisa de os criar: pode reutilizar os que já existem. Investigadores da Google treinaram o seu algoritmo word2vec com enormes conjuntos de dados e disponibilizaram publicamente os embeddings em várias línguas. Existem também outros algoritmos para criar word embeddings. Os mais conhecidos são o fastText da Facebook e o GloVe de Stanford. Pode descarregá-los e utilizá-los. Esta foi a primeira forma de transfer learning em NLP.
De word embeddings a text embeddings
Encontrámos, portanto, uma nova representação das palavras em que o significado está, de certa forma, codificado em números. Como podemos avaliar esta representação?
- Compreender o significado de palavras isoladas
- Parece que conseguimos fazê-lo muito bem! Os word embeddings de “animal” e “bicho” serão muito semelhantes
- Compreender a relação entre palavras
Como o nome indica, os word embeddings representam palavras, mas ainda não frases ou excertos de texto. Com BoW, conseguíamos pelo menos representar excertos de texto, mas como avançar agora? Uma abordagem frequente consistia em combinar recurrent neural networks (por exemplo, LSTM, GRU) com word embeddings. O texto é dividido em palavras e convertido numa sequência de word embeddings, que são lidos passo a passo. Em cada passo, a ‘memória’ interna da rede é atualizada, permitindo obter um embedding do texto completo. Este embedding é depois utilizado para a tarefa em causa (previsão, geração de texto, etc.).
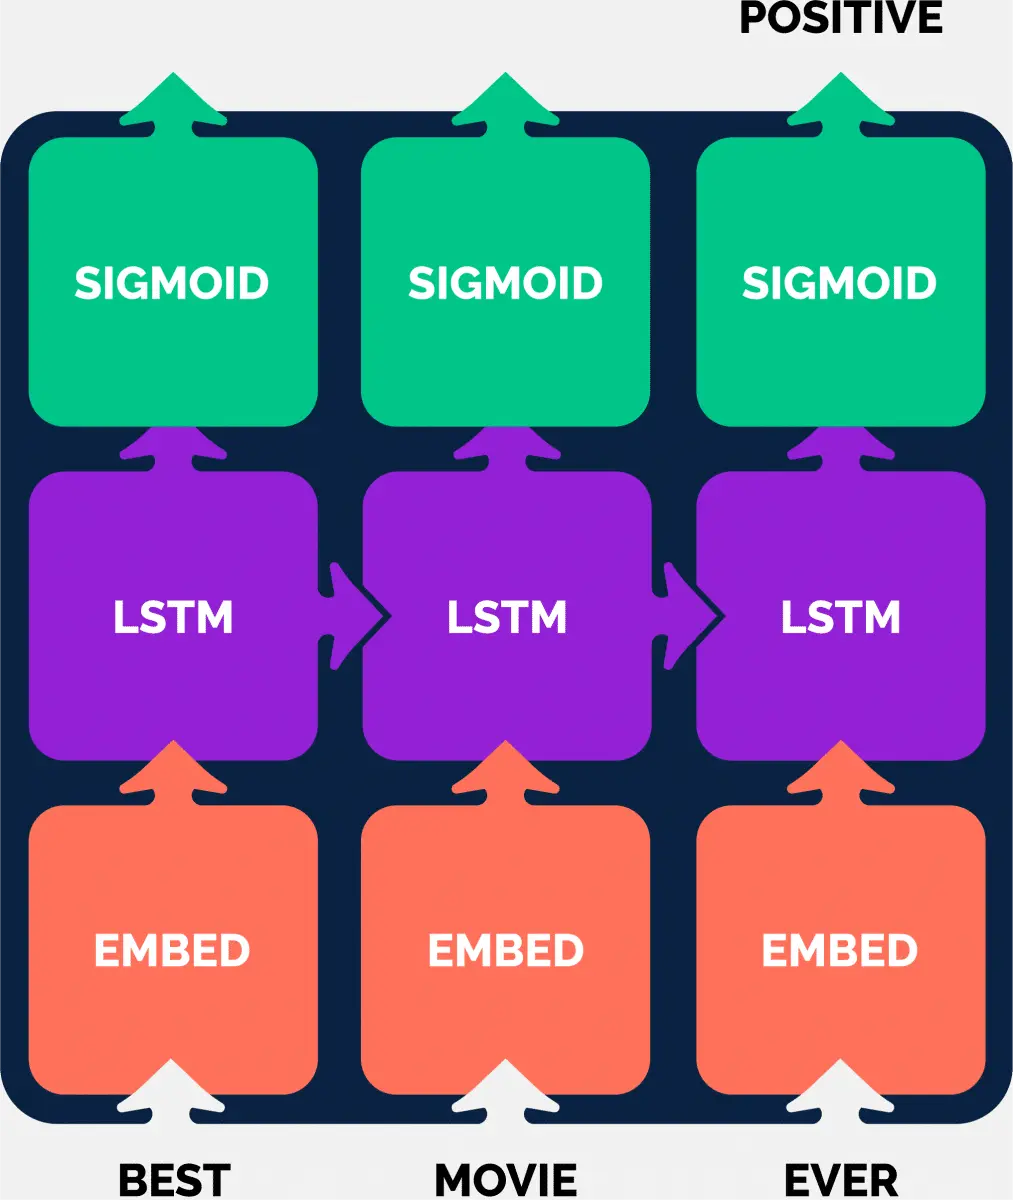
A partir daqui, podemos distinguir, de forma geral, duas abordagens:
- técnicas ‘diretas’ de text embeddings
- melhorias centradas na sensibilidade ao contexto
Text embeddings diretos
Existem várias técnicas para criar text embeddings. Em geral, são utilizadas para criar embeddings de frases ou parágrafos. Criar embeddings de páginas inteiras de texto de uma só vez ainda não funciona bem. O método mais simples (mas não necessariamente o pior) consiste em utilizar average word embeddings: calcular a média dos word embeddings de todas as palavras de um texto. A desvantagem é que este método ignora a ordem das palavras e inclui palavras irrelevantes. Este último problema pode ser resolvido atribuindo previamente pesos às palavras com tf/idf e calculando uma média ponderada. Seguiram-se várias outras abordagens. O algoritmo doc2vec[6] é, de certa forma, uma extensão do word2vec, em que o texto é incluído como contexto juntamente com as palavras individuais. Assim, as palavras e os textos são codificados no mesmo embedding space e podem ser comparados entre si. Nos skip-thought vectors[7], o algoritmo word2vec é alargado, substituindo as palavras por frases.
Passamos, portanto, de: “o significado de uma palavra é determinado pelas palavras entre as quais ocorre” para: “o significado de uma frase é determinado pelas frases entre as quais ocorre”. Para isso, são utilizadas RNNs (GRU) com word embeddings num modelo encoder-decoder.
Sensibilidade ao contexto
Outra linha de investigação centrou-se mais em ajudar as redes neuronais a lidar melhor com o contexto através de word embeddings. O conceito de attention surgiu como uma técnica para focar a atenção em determinadas partes do texto durante uma tarefa específica. No texto como um todo, há momentos em que uma seleção específica do texto (o contexto) é relevante. Com o aparecimento da arquitetura transformer, as arquiteturas anteriores baseadas em redes neuronais recorrentes e convolucionais foram substituídas por combinações de diferentes mecanismos de attention. Seguiu-se uma série de language models de grande escala baseados em transformers. Os modelos mais conhecidos, da família BERT, disponibilizam word embeddings pré-treinados e sensíveis ao contexto. A partir daqui, chegar aos text embeddings é um passo relativamente pequeno. O Sentence-BERT[8] (mais conhecido pelo termo sentence transformers) é uma boa implementação orientada para aplicações práticas. Chegámos assim a um marco importante: o transfer learning para NLP é finalmente uma realidade!
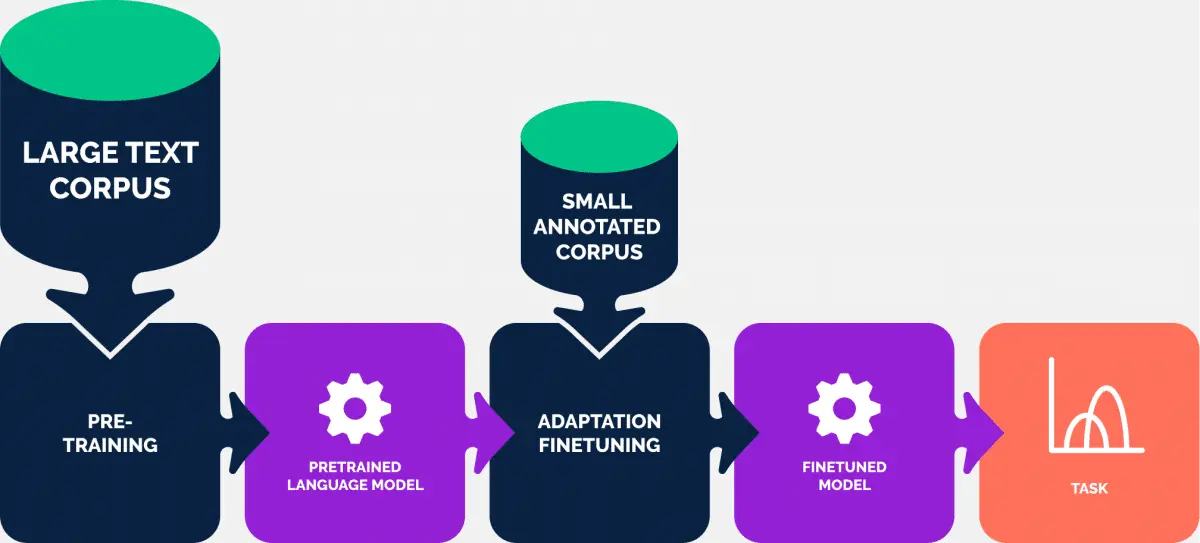
Em resumo
Agora que chegámos aos text embeddings, encontrámos uma forma de criar uma representação eficaz de um excerto de texto que capta tanto o significado das palavras como as relações entre elas (a estrutura da frase). Então basta descarregar um modelo pré-treinado, usá-lo para gerar embeddings para o nosso texto e começar? Dependendo da tarefa, isso é verdade até certo ponto. Pelo menos, em teoria.
Na parte 2, veremos até que ponto estas promessas se concretizam na prática…
Referências
[1] [Mikolov et al. 2013]
https://arxiv.org/abs/1301.3781
[2] [Bahdanau et al. 2014]
https://arxiv.org/abs/1409.0473
[3] [Vaswani et al. 2017]
https://arxiv.org/abs/1706.03762
[4] [Devlin et al. 2018]
https://arxiv.org/abs/1810.04805
[5]
https://en.wikipedia.org/wiki/Distributional_semantics
[6] [Le, Mikolov 2014]
https://arxiv.org/abs/1405.4053
[7] [Kiros et al. 2015]
https://arxiv.org/abs/1506.06726
[8] [Reimers, Gurevych 2019]
https://arxiv.org/abs/1908.10084