
Een generieke monitoring package voor Machine Learning modellen ontwikkeld voor Rijkswaterstaat
Rijkswaterstaat

We bouwen pipelines die modellen en rapportages dezelfde data geven, en meten wat er verschuift. Voor Rijkswaterstaat ontwikkelden we een generiek monitoring package.
Rijkswaterstaat bracht verschillende AI-modellen in productie. Handmatige monitoring op data- en prediction drift schaalt niet, dus ontwikkelden we een package voor drift- en outlierdetectie, met onder meer Python, Alibi Detect en Pydantic. “DSL is met een inventieve oplossing gekomen die we goed kunnen gebruiken.” Nanine Overgaauw, Rijkswaterstaat - SRE Data Science
Bij grote organisaties in en rond Utrecht voeden assetregisters, meetnetten, zaak- en planningssystemen samen de rapportages en modellen. Verandert één kolom of eenheid, dan rekent het model gewoon door. Wij bouwen pipelines die zo’n wijziging tegenhouden en zichtbaar maken.
Elke bron landt eerst ongewijzigd, daarna toetst de pipeline kolommen, typen en regels. Voor Fokker Services Group zitten datakwaliteitscontroles in het dataplatform.
Wat een model krijgt en teruggeeft, leg je vast. Daarop rust monitoring, zoals het package voor drift- en outlierdetectie voor Rijkswaterstaat.
Pipelines en infrastructuur gaan als code van ontwikkeling naar productie. Voor SNG automatiseerden we het releaseproces door de DTAP-straat, met onder meer Terraform.
Voor Vivara ontwikkelden we een dataplatform dat dagelijks data uit onder meer SAP, Magento en SharePoint haalt, met één datamodel voor alle afdelingen.
We volgen één model terug naar elke tabel en elk systeem dat het voedt, en wie er eigenaar van is.
Pipelines met schemacontrole en datakwaliteitsregels, plus een tabel met de invoer en uitkomsten van het model.
Het volgende model of rapport gebruikt dezelfde inname. Het beheer ligt daarna bij jullie team, of bij ons.
Meerdere modellen of rapportages draaien op data uit veel systemen, de inname is per project gebouwd en niemand merkt het als een bron verandert. Je zit in of rond Utrecht en wilt een team dat langskomt.
Je zoekt een data engineer die tijdelijk in je eigen team meebouwt: dan past detachering beter. Draait er nog niets op de data, begin dan bij de vraag welke beslissing beter moet.
Hoeveel bronnen en modellen er zijn, of er al een platform staat, hoe vaak data ververst, welke beveiligingseisen gelden en welk deel van het beheer je eigen team draagt.
We bouwen op Databricks, Microsoft Fabric of de omgeving die er al staat, en kiezen wat past bij het bestaande IT-landschap. Afspraken over documentatie en beheer leggen we vooraf vast.
Kies dit als één systeem de fout veroorzaakt en de beheerder hem kan oplossen, bijvoorbeeld met een verplicht veld of een vaste eenheid in het assetregister.
Kies dit als meerdere modellen en rapporten dezelfde bron gebruiken. Een schemacontrole of datakwaliteitsregel houdt de fout dan één keer tegen, voor iedereen.
Kies dit als de data technisch klopt maar de werkelijkheid verschuift. Ons advies: meet drift op de modelinvoer naast de controles in de pipeline, niet in plaats ervan.
Data Science Lab werkt sinds 2016 aan data en AI, vanuit Amsterdam. We bouwden dataplatforms voor onder meer Fokker Services Group en Vivara, en delen kennis in ons lab en op Techdays.
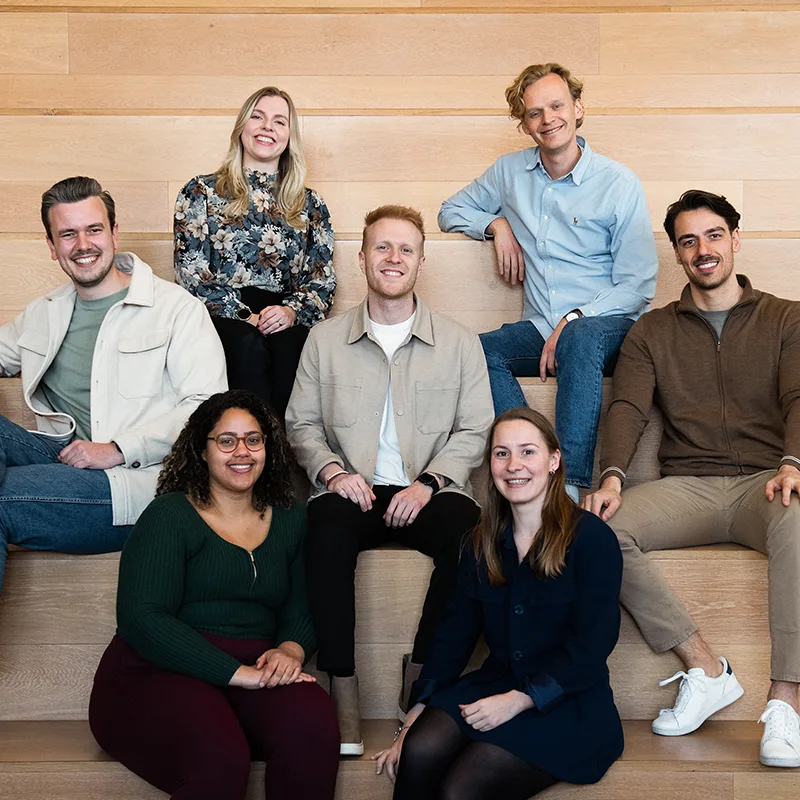
Stef is je eerste aanspreekpunt. In het eerste gesprek bespreken we je bronnen en modellen, bij jullie in Utrecht, in Amsterdam of online.
E-mail info@datasciencelab.nl
Telefoon +31 (0)20 3636 724
Vertel welke systemen, modellen en welk platform je gebruikt. Je krijgt antwoord per mail, of we plannen een eerste gesprek.
Bericht verstuurd
Bedankt voor je bericht. We nemen zo snel mogelijk contact met je op.
Het zorgt dat data uit al je systemen betrouwbaar op één plek komt, via pipelines en een platform die het ontwerpt, bouwt en onderhoudt. Bij modellen in productie hoort meer: dezelfde data voor training en productie, controles bij de inname en een vastgelegde modelinvoer. De modellen zelf zijn data science. Lees verder bij data engineering.
Wil je liever een data engineer uit Utrecht of omgeving in je eigen team, dan kan dat via een data engineer inhuren. Die collega is in dienst bij ons.
Omdat het model rekent op wat het bij de training zag. Wordt een bronsysteem vervangen, gaat een eenheid van meter naar centimeter of krijgt een kolom een andere betekenis, dan blijft het model uitkomsten geven, alleen kloppen ze minder. Een foutmelding krijgt niemand.
Zet de controle daarom in de inname. Delta-tabellen op Databricks dwingen het schema af bij het schrijven: kolommen die de tabel niet kent worden geweigerd en typen moeten overeenkomen. Een schemawijziging gaat dan bewust. Data die als bestand of via een API aankomt, kun je in Python valideren met Pydantic.
Door de invoer en de uitkomst van elke voorspelling op te slaan, naast de trainingsdata. Op Databricks doen inference tables dat: ze leggen de verzoeken en antwoorden van een model serving endpoint vast in een Delta-tabel in Unity Catalog. Met data profiling volg je daarop prestaties en data drift.
Rijkswaterstaat heeft verschillende AI-modellen in productie. Daarvoor ontwikkelden we een generiek package voor drift- en outlierdetectie, met onder meer Alibi Detect, een Python-bibliotheek voor outlier- en driftdetectie. Lees de case van Rijkswaterstaat of meer over MLOps.
Met lineage: een overzicht van welke queries en bestanden een tabel vullen, welke jobs en notebooks hem bewerken en welke dashboards en modelversies hem gebruiken. Unity Catalog legt dat automatisch vast voor queries op Databricks, tot op kolomniveau. Wil een bronbeheerder een kolom schrappen, dan zie je vooraf wie dat merkt.
Zonder zo’n catalogus kan het met een lijst per pipeline, maar die veroudert snel. Meer lees je bij Unity Catalog inrichten.
Voor AI-systemen met een hoog risico eist artikel 10 dat de trainings-, validatie- en testdata onder passende praktijken voor data governance en databeheer vallen. De datasets moeten relevant, voldoende representatief, zo veel mogelijk foutvrij en volledig zijn met het oog op het beoogde doel. Pipelines die vastleggen waar data vandaan komt, maken dat aantoonbaar.
Door de AI-omnibus gelden de eisen voor bijlage III pas vanaf 2 december 2027. Wij helpen met de inventarisatie; of jouw model hoog risico is, beslist je jurist of compliance-afdeling. Lees verder bij AI Act.
Dat hangt af van het IT-landschap dat er al staat. We bouwen op Databricks en Microsoft Fabric. Bij Fokker Services Group bouwen we aan een dataplatform op onder meer Databricks, Azure en dbt, gemodelleerd volgens de medaillonarchitectuur. Hoe brons, zilver en goud samen een lakehouse vormen, lees je bij een data lakehouse laten bouwen.
Komen er vooral gestructureerde bronnen en exports samen en draaien er geen modellen op, dan volstaat vaak een datawarehouse.
Als één rapport op één systeem draait, of als het probleem niet de techniek is maar dat niemand eigenaar is van een bron. Dan begin je bij afspraken over data governance, niet bij een pipeline. Mis je vooral handen in je eigen team, dan ligt detacheren meer voor de hand dan een project.
Zet je liever eerst een paar bureaus naast elkaar, gebruik dan de vergelijking van data engineering bureaus. Zit je in Zuid-Holland, lees dan over ons data engineering bureau in Rotterdam. Gaat het eerst om welk model je bouwt en wie het beheert, kijk dan bij AI consultant Utrecht.